# 《WaLiOffice - AI Agent 智能办公平台》第3-9节:图像生成——附件理解与图生图
作者:小傅哥
博客:https://bugstack.cn (opens new window)
沉淀、分享、成长,让自己和他人都能有所收获!😄
大家好,我是技术UP主小傅哥。
上一节我们打通了文生图:用户说“帮我生成一张科技感海报”,AI 直接出图。但实际工作中更高频的需求是:
- “参考这张图的设计风格,帮我生成另一张”
- “把我上传的产品图换个背景”
- “把这张照片里的人物换成商务着装”
这些就是图生图(image_to_image)。它的难度比文生图高不少:AI 生成时要“参考”一张已有图片——保持主体身份、构图、关键特征不变,同时按指令做局部修改。约束给松了,参考图白传;约束给死了,用户想要的改动又出不来。
本节围绕图生图讲四件事:
- 附件链路:用户上传的图片如何从 HTTP 请求一路走到 ToolContext,再进入图生图 API
- 模式检测与参考图收集:什么情况算图生图、参考图从哪来(参数与附件双通道)
- 提示词约束:图生图四段式结构 + preserve 语义的 Prompt 设计
- 附件理解(OCR):用 macOS Vision 框架识别图片里的文字,让 Agent“看懂”参考图内容
代码状态说明:图生图与文生图在同一个
image_prompt工具、同一个ch03-09-image-prompt分支里(参数契约在 3-8 已一步到位)。本节聚焦该分支中图生图视角的代码:collect_image_inputs、wants_image_to_image、reference_guidance、extra_body.image,以及附件侧的image_ocr.rs与 chat.rs 的意图路由。
# 一、本章诉求
- 理解附件数据结构:ChatAttachment(kind/mime_type/text_content/data_url)与 ToolContext.attachments 的注入时机
- 掌握参考图双通道收集:显式参数(image_url/image_urls)优先、会话附件(ctx.attachments)兜底
- 掌握图生图模式检测:显式 mode 参数 OR 参考图非空,二者其一即图生图
- 掌握图生图提示词设计:四段式结构 + reference_guidance 约束 + “保留/修改”语义显式化
- 理解 OCR 附件理解:data URL → 临时文件 → swift Vision 脚本 → OCR 文本注入对话上下文
- 理解媒体工具意图路由:上传图片 + 修图类关键词时,请求直接路由到 image 工具(跳过通用 LLM 决策)
# 二、流程设计
# 2.1 图生图完整链路
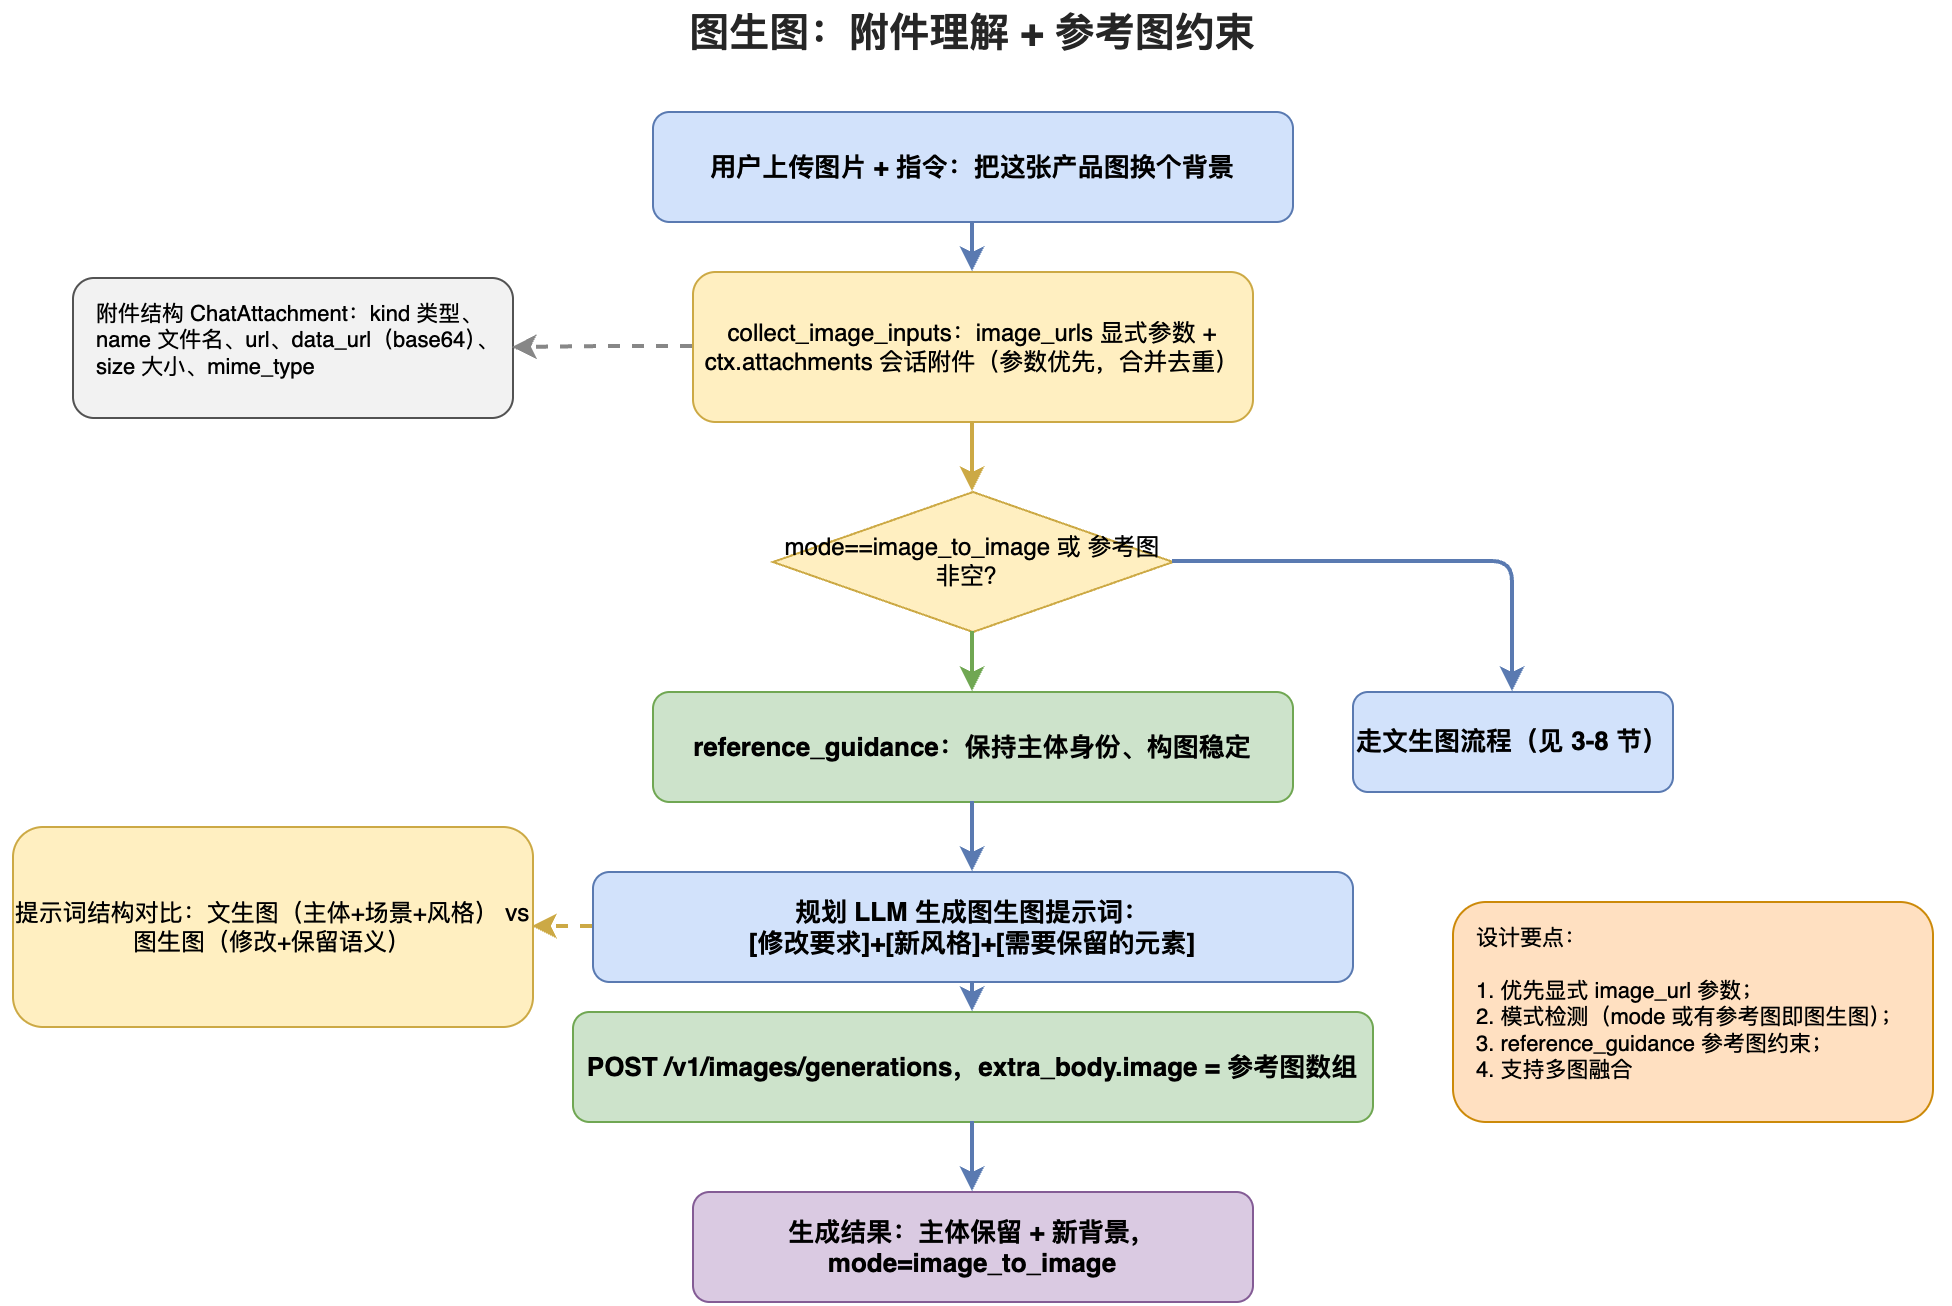
用户上传 product.jpg + 消息"把这张产品图换个深色科技感背景"
    ↓
① chat.rs:req.attachments 反序列化为 Vec<ChatAttachment>
   ├─ save_chat_attachments_to_files():附件存档
   └─ format_attachment_context():构建附件上下文
        ├─ 图片附件 → image_ocr::extract_text_from_attachment()
        │    data URL → 解码 → 临时文件 → /usr/bin/swift image_ocr.swift
        │    → macOS Vision (VNRecognizeTextRequest) → JSON{text}
        │    → "附件 N(图片)补充 OCR" 段落(截 1200 字符)
        └─ OCR 结果注入 SystemPrompt → Agent 知道图里写了什么字
    ↓
② infer_media_tool_kind(req):附件意图路由
   text 含"换背景/改图/图生图..." → 直接路由 image 工具(文本优先意图除外)
    ↓
③ ReAct 循环 → image_prompt(topic, mode=image_to_image)
    ↓
④ collect_image_inputs(ctx, input)
   参数无图 → ctx.attachments 里的 image 附件 → data_url
    ↓
⑤ wants_image_to_image = mode 显式指定 || !image_inputs.is_empty()  → true
    ↓
⑥ 规划 LLM(system 六段式/四段式 + reference_guidance 参考图约束)
   → 3 套图生图提示词
    ↓
⑦ Agnes API:request_body.extra_body.image = [data_url]
   → url/b64 返回(两层 Key 重试,同 3-8)
    ↓
ToolArtifact { kind: "image", generation_mode: "image_to_image",
               reference_image_count: 1, images, variants }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
👩🏻🏫敲黑板:注意链路里两条并行的“理解”通道——OCR 结果走 SystemPrompt 给 Agent 看(决定“改什么、保留什么”的规划质量),参考图本体走 extra_body.image 给 Agnes 模型看(决定“画什么”)。文字理解与像素理解分开服务,各喂各的模型。
京ICP备19031103号 | 
京公网安备 11030102010881号
| GPL Licensed | Copyright © 2019 小傅哥,All rights reserved.